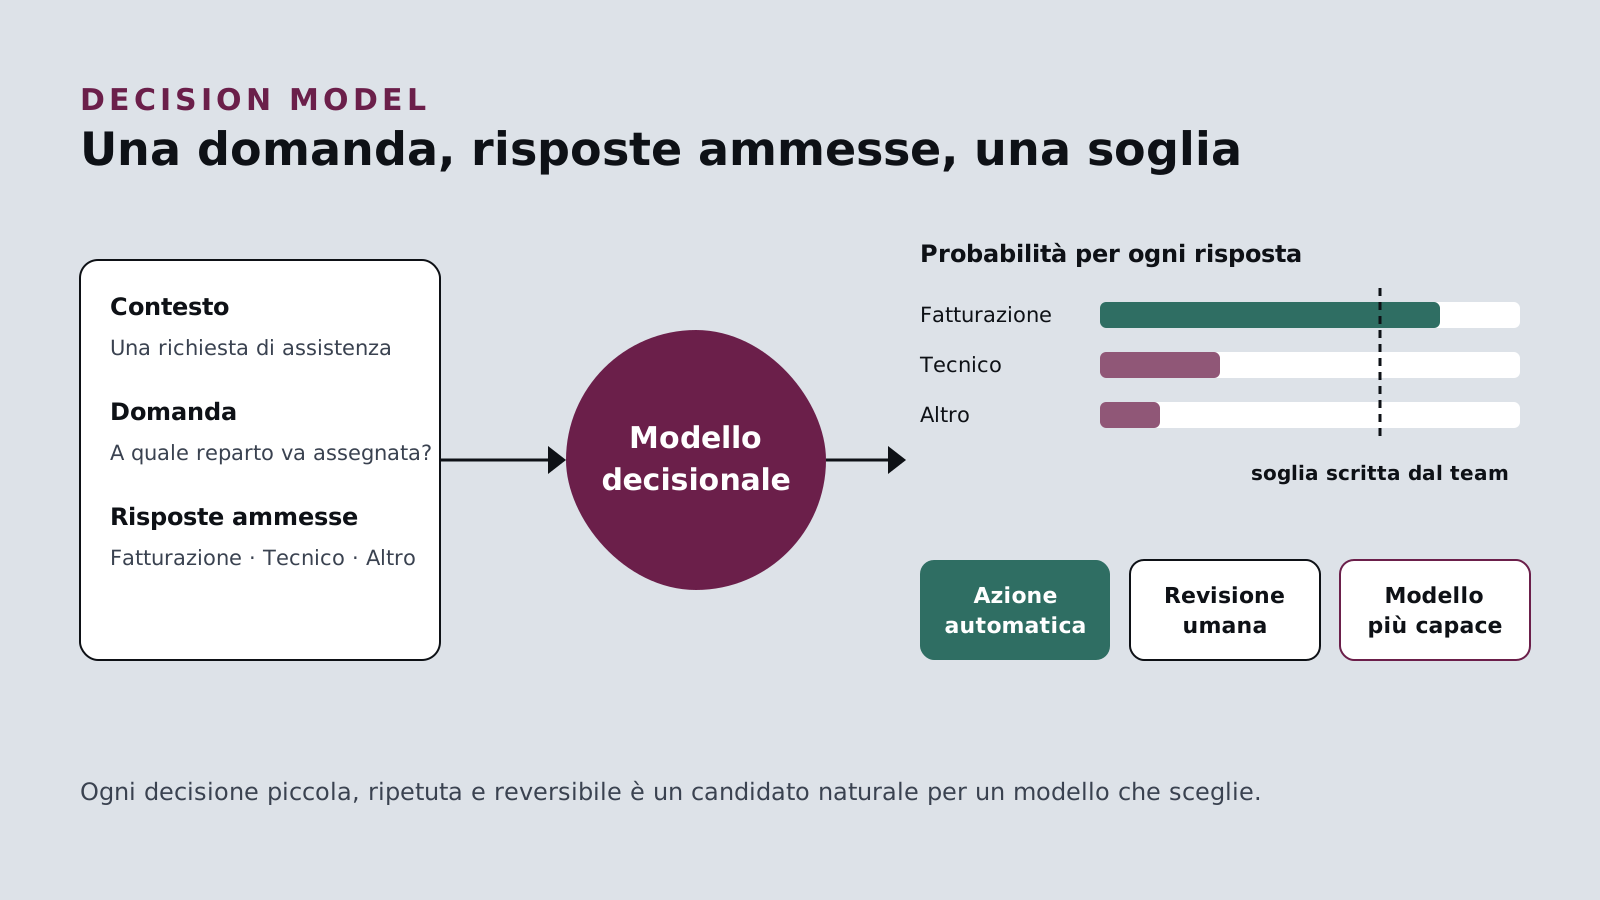
Un decision model è un modello di intelligenza artificiale che sceglie invece di scrivere. Riceve un contesto, una domanda e un insieme di risposte ammesse (sì o no, un’opzione fra tante, un punteggio su una scala) e restituisce in una sola chiamata la probabilità di ciascuna risposta. L’output ha sempre una forma valida, la risposta arriva in decine o centinaia di millisecondi e il prezzo di listino di TypeSafe AI e di Microsoft è di 0,042 dollari per milione di token in ingresso, con l’output gratuito.
Fino a poche settimane fa la categoria contava un solo protagonista. Fra il 4 e il 10 ottobre quattro fornitori di peso hanno portato i propri modelli decisionali in produzione o in anteprima, e il tema ha smesso di essere una curiosità per specialisti.
Che cos’è e perché interessa a un team
La categoria prende forma il 15 settembre con Jev di TypeSafe AI, che l’azienda riassume come stato destrutturato in ingresso e decisioni tipizzate e probabilistiche in uscita. Un modello linguistico scrive per un lettore. Un decision model scrive per il software, che agisce quando la confidenza supera la soglia scelta dal team e rinvia il resto a una persona o a un modello più capace.
Per un team il vantaggio sta nella forma della decisione. Una domanda con le sue risposte ammesse e una soglia sono oggetti che un gruppo può scrivere insieme, rivedere, versionare e misurare su casi reali. La regola che oggi vive nella testa di chi smista le richieste diventa un testo condiviso, discutibile e verificabile.
I casi quotidiani sono concreti: smistare un ticket per urgenza e per reparto, controllare l’azione proposta da un agente rispetto a una policy prima che parta, valutare con una rubrica le risposte di un assistente, classificare migliaia di feedback. Microsoft elenca fra gli usi il controllo degli agenti (continuare, fermarsi, riprovare, passare a una persona) e l’instradamento dei modelli in base a qualità, costo e latenza.
Sul piano dell’adozione dell’IA il decision model occupa un gradino intermedio. Dopo l’assistente che scrive e prima dell’agente autonomo, automatizza il giudizio ripetuto di piccole dimensioni e lascia al team la parte che conta: scegliere le domande e il livello di rischio accettabile. Nella produzione con modelli di IA il disegno che emerge assegna al modello grande il ragionamento e la scrittura, e al modello decisionale lo smistamento e il controllo, a costo e latenza molto inferiori.
I rilasci dal 4 al 10 ottobre
All’inizio del mese Cloudflare, con Clef da 27 e 9 miliardi di parametri, pesi aperti e contesto da 64.000 token, e AWS Strands Labs, con Decider 2B, avevano mosso la parte aperta del mercato. La settimana appena chiusa sposta la categoria verso le piattaforme dei grandi fornitori.
| Data | Fornitore e modello | Accesso | Dati dichiarati dal fornitore |
|---|---|---|---|
| 29 set, beta in settimana | OpenAI, Decisions API su GPT-6 Luna | public beta, endpoint dedicato | circa 150 ms per risposta contro 1,6 s di Luna in chat |
| 7 ott | Snowflake Decision, tramite AI_COMPLETE | private preview | 57,63 punti sul Jev Decision Index 0.2.1 fra 72 modelli (valutazione interna) |
| 8-9 ott | Liquid AI, d1-3B e d1-omni-600M | pesi aperti su Hugging Face | 8 ms su RTX 4090 e 50 ms su Jetson Orin Nano per una domanda |
| 9 ott | Microsoft-Decision-1, da Qwen3.5-9B | Microsoft Foundry | 85 ms di p50 e 83,5 % di accuratezza media su 36 benchmark |
Microsoft-Decision-1 è il rilascio più articolato. Il modello deriva da Qwen3.5-9B di Alibaba, accetta testo con un contesto da 32.768 token e costa 0,042 dollari per milione di token in ingresso, con l’output gratuito. Microsoft dichiara 147.137 domande tenute fuori dall’addestramento e una decisione che cambia nell’1,3 % delle perturbazioni, zero volte con parafrasi o riordino delle opzioni. Nei casi interni, lo smistamento di oltre 10.000 feedback per Xbox risulta 14 volte più veloce e circa 200 volte più economico di GPT-6 Sol, e il controllo qualità per Copilot risulta 100 volte più veloce. L’azienda annuncia che ripeterà l’addestramento sui modelli sviluppati da Microsoft AI e su quelli di OpenAI.
OpenAI e Snowflake portano la stessa idea dove vivono già applicazioni e dati. La Decisions API di OpenAI, presentata in anteprima il 29 settembre, è ora in public beta. Snowflake espone tre tipi di domanda (scelta, punteggio, vero o falso) dentro AI_COMPLETE e permette di valutare le righe di una tabella con una sola istruzione SQL, mantenendo i controlli di accesso e di audit già in uso.
Liquid AI guarda ai dispositivi: d1-3B legge testo e immagini e ottiene 48,57 sul Decision Index, un benchmark della stessa Liquid AI, mentre d1-omni-600M aggiunge visione e audio in un modello da 600 milioni di parametri. Il testo della licenza va verificato sulla pagina Hugging Face prima dell’adozione.
Il 4 ottobre un benchmark indipendente su Jev, basato su 16.379 richieste live, ha concluso che il modello è utile per scelte delimitate e resta lontano da un modello di ragionamento di frontiera.
Le vulnerabilità da conoscere
- Benchmark dei fornitori. I 36 benchmark e le latenze di Microsoft sono dati dell’azienda. H2O contesta il metodo impiegato per la latenza dei concorrenti e indica 29 ms misurati per il proprio modello, mentre Microsoft-Decision-1 è in attesa di risultati indipendenti su JevBench. Anche gli indici di Liquid AI e di Snowflake sono valutazioni interne.
- Forma valida e decisione corretta. Un’etichetta ben formata può essere sbagliata. Il benchmark indipendente su Jev segnala che il campo di confidenza deriva in buona parte dalla probabilità più alta e dal numero di opzioni, e quindi offre un segnale debole sulla correttezza.
- Perimetro di competenza. L’output di Microsoft-Decision-1 contiene la risposta e la probabilità, e la spiegazione resta fuori. Il modello legge solo testo, regge poco il ragionamento in più passaggi e, come ogni sistema che valuta linguaggio naturale, resta esposto alla prompt injection.
- Provenienza e pesi. Decision-1 poggia su un modello aperto di un laboratorio cinese e i suoi pesi restano chiusi, quindi la filiera si verifica sulle dichiarazioni del fornitore.
- Decisioni sulle persone. La model card richiede supervisione umana per credito, lavoro, abitazione, sanità e diritti legali. Per queste aree servono soglie, percorsi di escalation e registrazione delle decisioni.
- Stato dei prodotti e dei prezzi. Snowflake è in private preview, la beta di OpenAI può cambiare e un prezzo di lancio può risultare sovvenzionato. Oltre cento modelli decisionali sono già disponibili, quindi la scelta del fornitore richiede una prova sui propri dati.
Da dove partire
Le azioni valgono per qualunque fornitore e per qualunque team.
- Elencare le decisioni a risposta chiusa che qualcuno prende decine di volte al giorno, per esempio a chi assegnare una richiesta o se un’azione rispetta una policy.
- Scrivere per ciascuna la domanda, le risposte ammesse e un’opzione di rinvio a una persona.
- Raccogliere qualche centinaio di casi reali già etichettati e misurare più modelli sullo stesso campione, includendo come riferimento un classificatore tradizionale.
- Fissare tre percorsi di soglia (azione automatica, revisione umana, rinvio a un modello più capace) e verificare la calibrazione sui propri dati, anche con parafrasi e riordino delle opzioni.
- Registrare ogni decisione e rivedere le soglie a cadenza fissa, con un responsabile indicato per ciascuna domanda.
La domanda per i prossimi mesi riguarda la forma che prenderà la categoria: uno strato di mercato autonomo, con decine di fornitori specializzati, oppure una funzione assorbita dalle piattaforme di dati e di cloud, come suggeriscono le scelte di Snowflake e di Microsoft.
Autore
Pablo Liuzzi
Founder, Synthos Logic
Fonti
- "Introducing Microsoft-Decision-1, our model for fast decision-making" — Microsoft Command Line, 9 ottobre 2026
- "Microsoft leans on open weight model from Chinese AI lab to challenge Jev" — The Register, 10 ottobre 2026
- "Microsoft AI Releases Microsoft-Decision-1: A Qwen3.5-9B Decision-Scoring Model" — MarkTechPost, 9 ottobre 2026
- "Oct 7, 2026: Snowflake Decision with AI_COMPLETE (Private Preview)" — Snowflake Documentation, 7 ottobre 2026
- "Introducing Snowflake Decision in Cortex AI Functions" — Snowflake Blog, 8 ottobre 2026
- Decisions API di OpenAI basata su GPT-6 Luna — The New Stack, 29 settembre 2026
- "Liquid AI Opens d1-3B and d1-omni-600M Decision Models" — AI Weekly, 8-9 ottobre 2026
- Cloudflare Clef, modelli decisionali a pesi aperti — InfoQ, 8 ottobre 2026
- "AI Weekly Intelligence #017: The Rise Of Decision Models" — AI Tools Directory, 6 ottobre 2026
- "Jev benchmark finds a useful decision model, not a frontier reasoner" — remio.ai, 4 ottobre 2026